세특 탐구 주제 시리즈 #7 · 고등학교 수학으로 생활 속 궁금증을 직접 계산해 보는 시리즈입니다. 이번 주제는 확률과 통계의 이항분포, 정규분포, 모비율 추정입니다.
선거철 뉴스에는 늘 같은 문장이 붙습니다. "이번 조사는 전국 만 18세 이상 1,000명을 대상으로 했으며, 95% 신뢰수준에 표본오차는 ±3.1%p입니다." 4,400만 명이 넘는 유권자 가운데 겨우 1,000명에게 물었는데 어떻게 오차가 3.1%p밖에 안 된다고 자신할까요? 그리고 3.1이라는 숫자는 어디서 나왔을까요? 통계학이나 언론·미디어 쪽으로 진로를 생각하는 학생이라면 앞으로 수없이 보게 될 숫자이니, 이번 글에서 직접 계산해 보겠습니다.
주요단어: 여론조사, 오차범위, 표본오차, 신뢰수준, 표본비율, 모비율 추정, 이항분포, 정규분포, 확률과 통계, 고등학교, 주제탐구
① 먼저 알아 둘 것, 전체가 아니라 일부에게 묻는다
알고 싶은 집단 전체를 모집단, 실제로 물어본 사람들을 표본이라고 합니다. 유권자 4,400만 명 모두에게 묻는 일은 선거 그 자체라서, 여론조사는 1,000명 정도의 표본만 뽑아 묻습니다.
이때 표본은 무작위로 뽑아야 합니다. 특정 지역이나 특정 나이대만 골라 물으면 아무리 많이 물어도 전체를 대표하지 못합니다. 그래서 실제 조사에서는 전화번호를 무작위로 만들어 걸고, 지역·성별·나이 비율을 인구 구성에 맞춥니다.
문제는 무작위로 뽑으면 뽑을 때마다 결과가 조금씩 달라진다는 것입니다. 오차범위는 이 흔들림이 얼마나 큰지를 숫자로 나타낸 것입니다.
② 10명, 100명, 1,000명에게 물어보면
어떤 정책에 실제로 찬성하는 사람이 정확히 50%라고 해 봅시다. 여기서 10명을 무작위로 뽑아 물으면 찬성하는 사람 수 X는 이항분포 B(10, 0.5)를 따릅니다. 찬성자가 정확히 5명일 확률을 계산하면 이렇습니다.
P(X = 5) = 10C5 × 0.55 × 0.55 = 252 × 1/1024 = 252/1024 ≈ 0.246
정답인 50%가 나올 확률이 4분의 1도 안 됩니다. 반대로 찬성자가 3명 이하, 즉 "찬성 30% 이하"라는 엉뚱한 결과가 나올 확률도 계산해 볼까요?
| 찬성자 수 | 계산 | 확률 |
|---|---|---|
| 0명 | 10C0/1024 = 1/1024 | 0.0010 |
| 1명 | 10C1/1024 = 10/1024 | 0.0098 |
| 2명 | 10C2/1024 = 45/1024 | 0.0439 |
| 3명 | 10C3/1024 = 120/1024 | 0.1172 |
| 합계 | 176/1024 | 0.1719 |
10명에게 물으면 6번에 1번꼴로 "찬성 30% 이하"가 나옵니다. 이런 조사는 믿기 어렵죠. 사람 수를 늘리면 어떻게 될지 100명, 1,000명일 때도 같은 방법으로 모든 경우의 확률을 계산해 그래프로 그렸습니다.
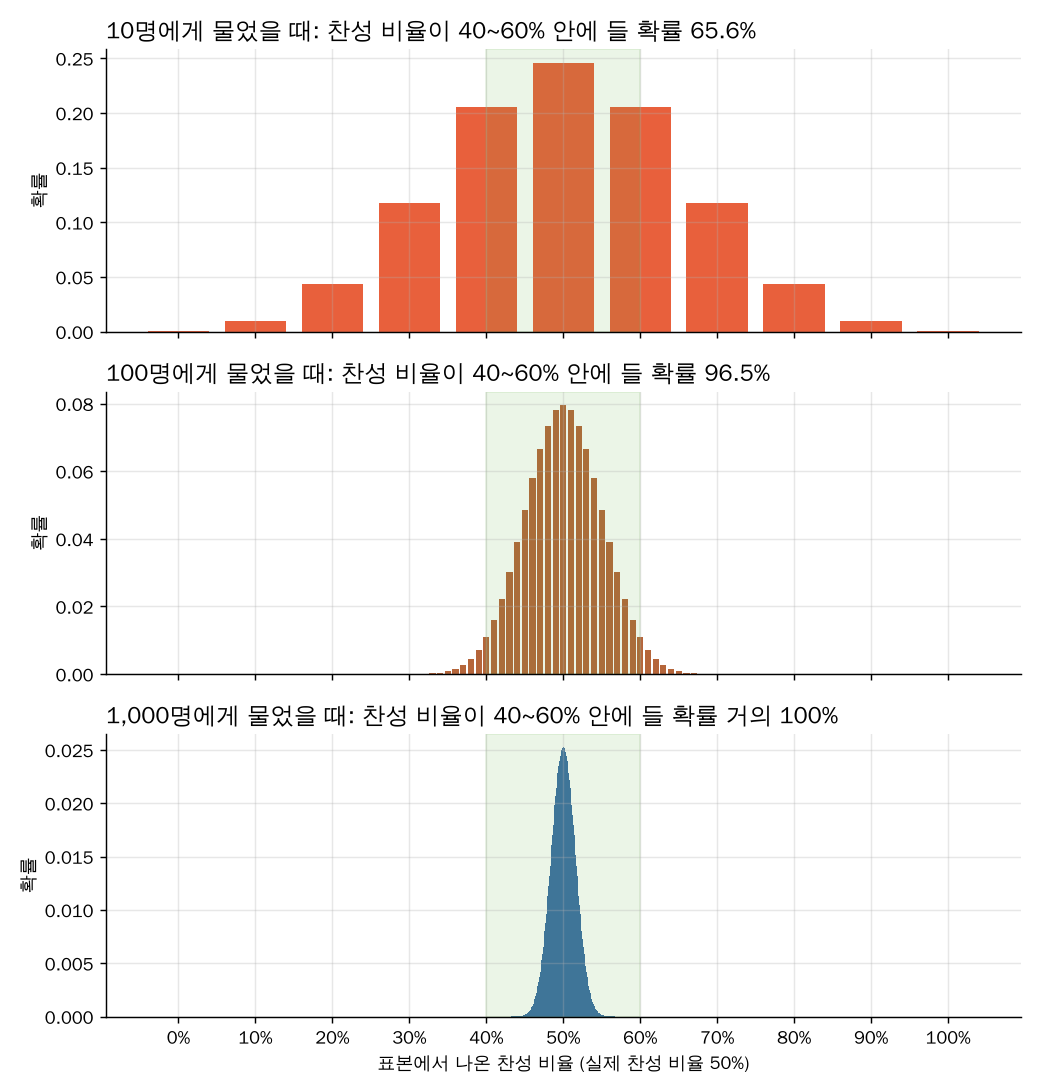
10명일 때는 막대가 0%부터 100%까지 넓게 퍼져 있지만, 1,000명이 되면 거의 모든 결과가 45~55% 사이에 몰립니다. 많이 물을수록 결과가 실제 값 근처로 모인다는 것을 눈으로 확인할 수 있습니다. 이제 이 "퍼진 정도"를 숫자로 계산해 보겠습니다.
③ 표본비율은 얼마나 흩어질까
교과서에서 배운 이항분포의 평균과 표준편차 공식을 그대로 씁니다. X가 B(n, p)를 따르면
E(X) = np, σ(X) = √(np(1 − p))
1,000명에게 묻고 실제 찬성률이 0.5라면 한 단계씩 넣어 봅니다.
- 평균: 1000 × 0.5 = 500명
- 분산: 1000 × 0.5 × 0.5 = 250
- 표준편차: √250 ≈ 15.81명
뉴스에 나오는 것은 사람 수가 아니라 비율입니다. 찬성 비율 p̂ = X/1000이므로 평균과 표준편차를 모두 1000으로 나눕니다.
- 표본비율의 평균: 500 ÷ 1000 = 0.5 (실제 찬성률과 같음)
- 표본비율의 표준편차: 15.81 ÷ 1000 ≈ 0.01581, 즉 약 1.58%p
이 과정을 문자로 정리하면 표본비율의 표준편차는 √(p(1 − p)/n)이 됩니다. 넣어서 다시 확인해 보면 √(0.5 × 0.5 ÷ 1000) = √0.00025 ≈ 0.01581로 같습니다. 여기서 p에 50을 넣는 실수가 많은데, 비율이므로 0.5를 넣어야 합니다.
④ 3.1의 정체는 1.96 × 1.58
n이 충분히 크면 이항분포는 정규분포에 가까워집니다. 그림1의 1,000명 그래프가 종 모양인 것도 그래서입니다. 그러면 표준정규분포표를 쓸 수 있습니다. 표에서 P(0 ≤ Z ≤ 1.96) = 0.4750을 찾으면
P(−1.96 ≤ Z ≤ 1.96) = 0.4750 × 2 = 0.95
즉 표본비율은 95%의 확률로 "실제 비율 ± 1.96 × 표준편차" 안에 들어옵니다. 앞에서 구한 표준편차를 넣으면
1.96 × 0.01581 = 0.0310 → ±3.1%p
뉴스의 "95% 신뢰수준에 ±3.1%p"가 정확히 이 계산입니다. 그런데 실제 찬성률을 모르는데 왜 0.5를 넣었을까요? p(1 − p)는 p가 0.5일 때 가장 커서 오차범위도 가장 크게 나오기 때문입니다.
| p | p(1 − p) | 1,000명일 때 오차범위 |
|---|---|---|
| 0.1 | 0.09 | 1.96 × √(0.09/1000) ≈ ±1.9%p |
| 0.3 | 0.21 | 1.96 × √(0.21/1000) ≈ ±2.8%p |
| 0.42 | 0.2436 | 1.96 × √(0.2436/1000) ≈ ±3.06%p |
| 0.5 | 0.25 | 1.96 × √(0.25/1000) ≈ ±3.10%p |
그래서 조사 기관은 "가장 나쁜 경우에도 이 정도"라는 뜻으로 0.5를 넣은 값을 발표합니다. 실제 지지율이 42%로 나온 후보라면 오차범위는 ±3.06%p로 조금 더 좁습니다.
⑤ 95%는 무슨 뜻일까
실제 지지율이 42%인 후보가 있다고 정해 놓고, 컴퓨터로 1,000명 여론조사를 100번 했습니다. 조사마다 나온 지지율에 ±오차범위를 붙여 구간을 그리면 아래와 같습니다.
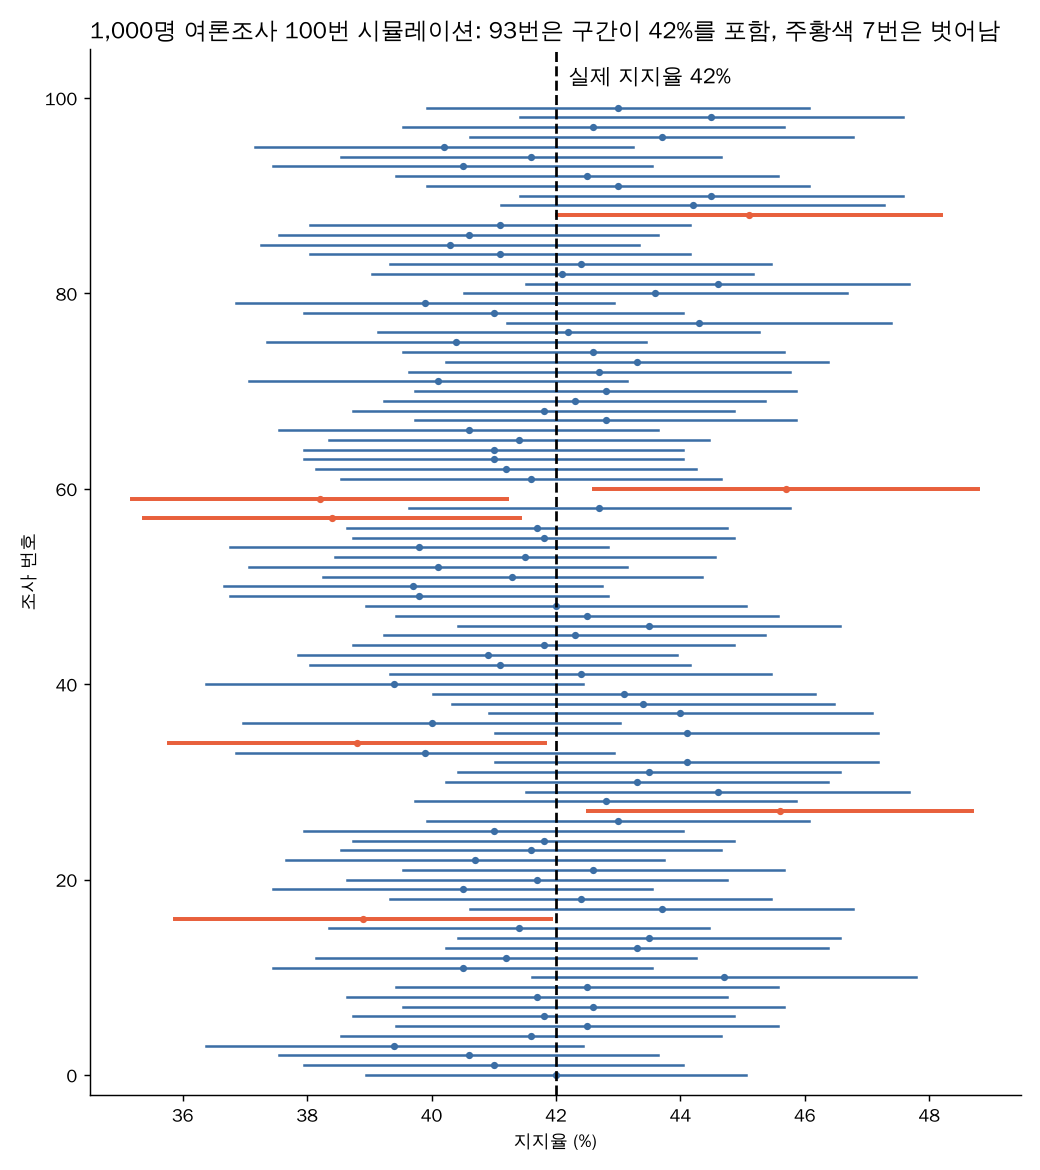
100개 구간 가운데 93개가 진짜 값 42%를 지나가고, 주황색 7개는 비켜 갔습니다. 이론대로라면 95개 정도가 맞아야 하는데, 100번만 해 보면 이렇게 93이나 97처럼 조금씩 다르게 나옵니다. 시행 횟수를 늘리면 95%에 점점 가까워집니다.
95% 신뢰수준은 "이런 방법으로 구간을 만들면 100번 중 95번 정도는 진짜 값을 포함한다"는 뜻입니다. 우리가 뉴스에서 보는 조사는 이 100개 중 하나이고, 그게 주황색인지 파란색인지는 아무도 모릅니다. 여론조사 결과를 하나의 정답으로 받아들이면 안 되는 이유가 여기 있습니다.
⑥ 몇 명에게 물어야 할까
오차를 줄이려면 더 많이 물으면 됩니다. 그런데 얼마나 많이 물어야 할까요? n을 바꿔 가며 1.96 × √(0.25/n)을 계산했습니다.
| 조사 인원 | 계산 | 오차범위 |
|---|---|---|
| 30명 (한 반) | 1.96 × √(0.25/30) = 1.96 × 0.0913 | ±17.9%p |
| 500명 | 1.96 × √(0.25/500) = 1.96 × 0.0224 | ±4.4%p |
| 1,000명 | 1.96 × √(0.25/1000) = 1.96 × 0.0158 | ±3.1%p |
| 2,000명 | 1.96 × √(0.25/2000) = 1.96 × 0.0112 | ±2.2%p |
| 4,000명 | 1.96 × √(0.25/4000) = 1.96 × 0.0079 | ±1.5%p |
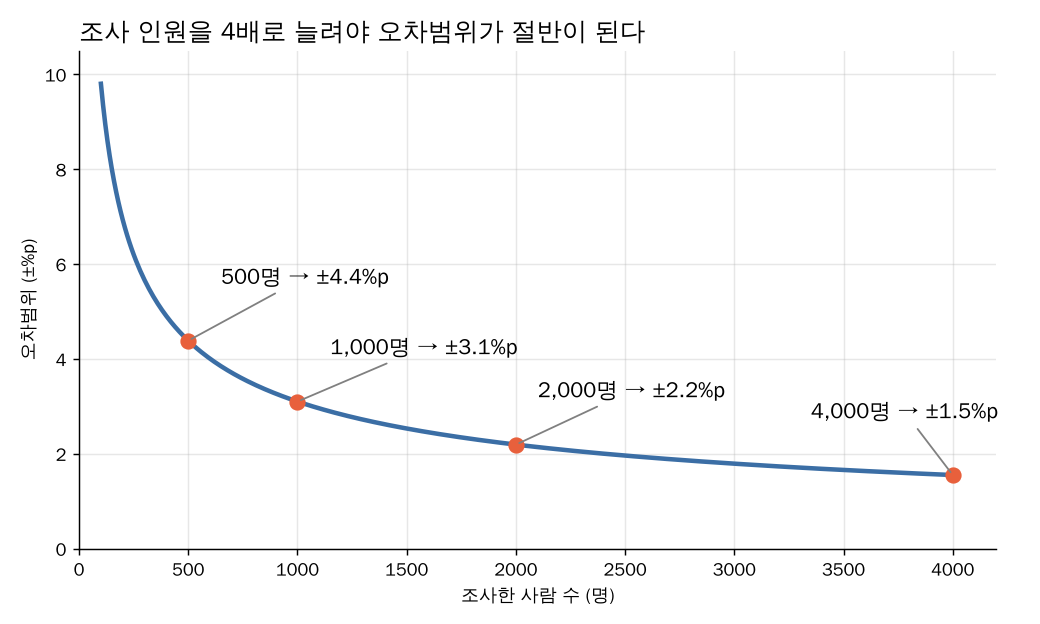
1,000명에서 4,000명으로 4배를 늘려야 오차범위가 3.1에서 1.5로 절반이 됩니다. n이 근호 안에 있어서 √4 = 2배만큼만 줄어드는 것이죠. 조사 비용은 사람 수에 비례해 늘어나니, 대부분의 여론조사가 1,000명 안팎에서 멈추는 데는 이런 계산이 깔려 있습니다.
반 친구 30명에게 물은 설문으로 "우리 학교 학생의 60%가 찬성"이라고 쓰면 실제로는 42%에서 78% 사이 어디쯤이라는 말과 같습니다. 학교 설문으로 탐구할 때 꼭 함께 적어 두면 좋은 숫자입니다.
그렇다면 모집단의 크기는 상관이 없을까요? 공식에 모집단 크기가 들어 있지 않습니다. 모집단이 표본보다 충분히 크면 서울시장 선거든 대통령 선거든 1,000명에게 물었을 때의 오차범위는 거의 같습니다. 국은 맛을 볼 때 냄비 크기와 상관없이 잘 저어서 한 숟가락만 뜨면 되는 것과 비슷합니다.
⑦ 뉴스 읽기, "오차범위 내 접전"
1,000명 조사에서 후보 A가 42%, 후보 B가 38%라면 A가 이기고 있는 걸까요? 두 후보에 각각 ±3.1%p를 붙여 보면 답이 보입니다.
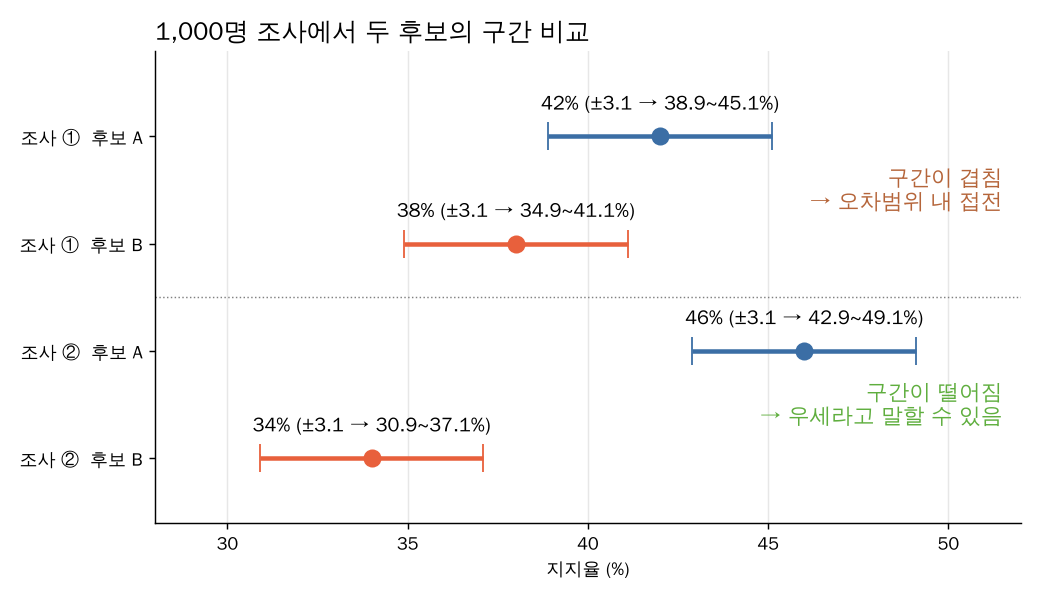
- 조사 ①: A는 38.9~45.1%, B는 34.9~41.1%입니다. 38.9~41.1% 구간이 겹치므로 실제로는 B가 앞설 가능성도 있습니다. 이럴 때 뉴스는 "오차범위 내 접전"이라고 씁니다.
- 조사 ②: A는 42.9~49.1%, B는 30.9~37.1%입니다. 구간이 전혀 겹치지 않으니 A가 앞선다고 말할 수 있습니다.
그러니 지지율 차이가 4%p라는 숫자만 보고 "A 우세"라는 제목을 단 기사는 조심해서 읽어야 합니다. 조사 인원이 몇 명인지, 오차범위가 얼마인지 기사 끝을 확인하는 습관이 필요합니다.
⑧ 이 주제로 탐구보고서를 쓴다면
- 탐구 질문과 가설: "1,000명만 조사한 여론조사를 믿어도 될까?" → 가설: 무작위로 뽑으면 1,000명만으로도 95%의 확률로 실제 값과 3.1%p 이내로 맞는다.
- 자료 수집과 계산: 학급 또는 학년 전체에 "급식 만족 여부" 같은 설문을 하고, 그중 10명·30명·50명을 무작위로 여러 번 뽑아 표본비율이 어떻게 흩어지는지 기록한다. 이항분포의 표준편차 √(p(1 − p)/n)으로 계산한 값과 비교한다.
- 그래프: 표본 크기별 표본비율의 히스토그램(그림1처럼)과, 표본마다 만든 구간을 세로로 늘어놓은 그래프(그림3처럼)를 그린다. 엑셀이나 파이썬으로 100번 반복하면 실제로 몇 개가 전체 비율을 포함하는지 셀 수 있다.
- 결론과 한계: "30명 표본의 오차범위는 ±17.9%p로, 학급 설문만으로 학교 전체를 말하기 어렵다"처럼 수치로 결론을 쓴다. 한계로는 응답을 거절한 사람이 많으면 무작위가 깨진다는 점, 두 후보의 차이에 대한 오차범위는 각자의 오차범위와 따로 계산해야 한다는 점(42% 대 38%라면 차이 4%p의 오차범위는 약 ±5.5%p)을 적는다.
더 나아가 보고 싶다면 이런 질문도 좋습니다.
- 신뢰수준을 99%로 높이면 1.96 대신 2.58을 쓴다. 같은 1,000명이면 오차범위는 얼마가 될까?
- 오차범위를 ±1%p로 줄이려면 몇 명에게 물어야 할까? (1.96 × √(0.25/n) = 0.01을 n에 대해 풀어 보기)
- 지난 선거의 마지막 여론조사와 실제 득표율을 비교하면 오차범위 안에 들어왔을까?
함께 읽으면 좋은 시리즈 글
- 확률과 통계로 유전을 계산하면: 고등학교 수학으로 탐구하는 생명과학의 다인자 유전
- 자료에 가장 잘 맞는 직선 찾기: 선형회귀법의 수학적 원리 (기초행렬편)
- 숫자로 판단하는 또 다른 생활 속 수학: 대출 상환액과 예금·적금 이자는 어떻게 정해질까
다음 글 예고: 로또 1등 확률은 정말 814만분의 1일까요? 1,000원짜리 로또 한 장의 기댓값은 얼마일까요? 다음 시리즈에서는 조합과 기댓값으로 로또를 끝까지 계산해 봅니다.
세특 탐구 주제 시리즈는 매주 새 글이 올라옵니다. 블로그를 구독해 두시면 새 탐구 주제를 놓치지 않고 받아 보실 수 있습니다.
'교육(학업) > 수학 탐구' 카테고리의 다른 글
| [마케팅·통계·수학 진로] 고등학교 수학으로 로또 확률과 기댓값 탐구하기: 1,000원짜리 복권의 진짜 값 (0) | 2026.11.09 |
|---|---|
| [생명과학·환경 진로] 고등학교 수학으로 로지스틱 성장 탐구하기: 생물의 수는 왜 끝없이 늘지 않을까 (0) | 2026.11.05 |
| [약학·의학 진로] 고등학교 수학으로 약 복용 간격 탐구하기: 반감기와 등비수열의 합 (0) | 2026.11.05 |
| [컴퓨터공학 진로] 고등학교 수학으로 72의 법칙 계산기 만들며 탐구하기: 반복문·로그로 배우는 코딩 (0) | 2026.11.03 |
| [경영·경제 진로] 고등학교 수학으로 대출·예금·적금 이자 탐구하기: 등차·등비수열로 직접 계산 (0) | 2026.11.02 |